
Arquitectura de colas: confirmación, idempotencia, reintentos y mensajes fallidos
Una cola desacopla sistemas, pero no elimina el trabajo pendiente: lo traslada. Principios de diseño para confirmar en el momento correcto, evitar efectos duplicados, reintentar con criterio y operar la cola de mensajes fallidos.
Una cola permite que una aplicación acepte trabajo sin esperar a que otra termine de ejecutarlo. La separación es útil cuando el destino está temporalmente saturado, cuando un proceso tarda más que la respuesta de una API o cuando las tareas deben repartirse entre varios consumidores.
El trabajo pendiente, sin embargo, no desaparece al trasladarlo a un intermediario. Antes de elegir un producto deben definirse tres cosas: qué significa completar una tarea, cuánto puede esperar y quién interviene cuando no se procesa. Este artículo desarrolla los principios de diseño que se derivan de esas definiciones, con referencias a RabbitMQ y OCI Queue.
Criterio de uso de una cola
Un caso ilustrativo: la generación de un documento después de registrar una solicitud. La aplicación guarda la solicitud y entrega una referencia para consultar su estado, mientras un consumidor prepara el documento. El usuario debe poder distinguir entre «solicitud aceptada» y «documento listo»; una respuesta favorable al envío no demuestra que el trabajo terminó.
Una cola de trabajo reparte tareas entre consumidores que compiten por procesarlas. El tutorial oficial de colas de trabajo de RabbitMQ describe el patrón y la recuperación de entregas no confirmadas. Si varias aplicaciones necesitan conservar y releer el mismo historial de eventos, el modelo adecuado es otro: un registro de eventos con retención.
La asincronía no es apropiada cuando la operación necesita una respuesta inmediata del destino para continuar. Si una autorización debe validarse antes de aceptar una transacción, dejar ese paso pendiente cambia el contrato del servicio. Como criterio, la cola se reserva para trabajo que admite un estado intermedio explícito y un procedimiento de recuperación.
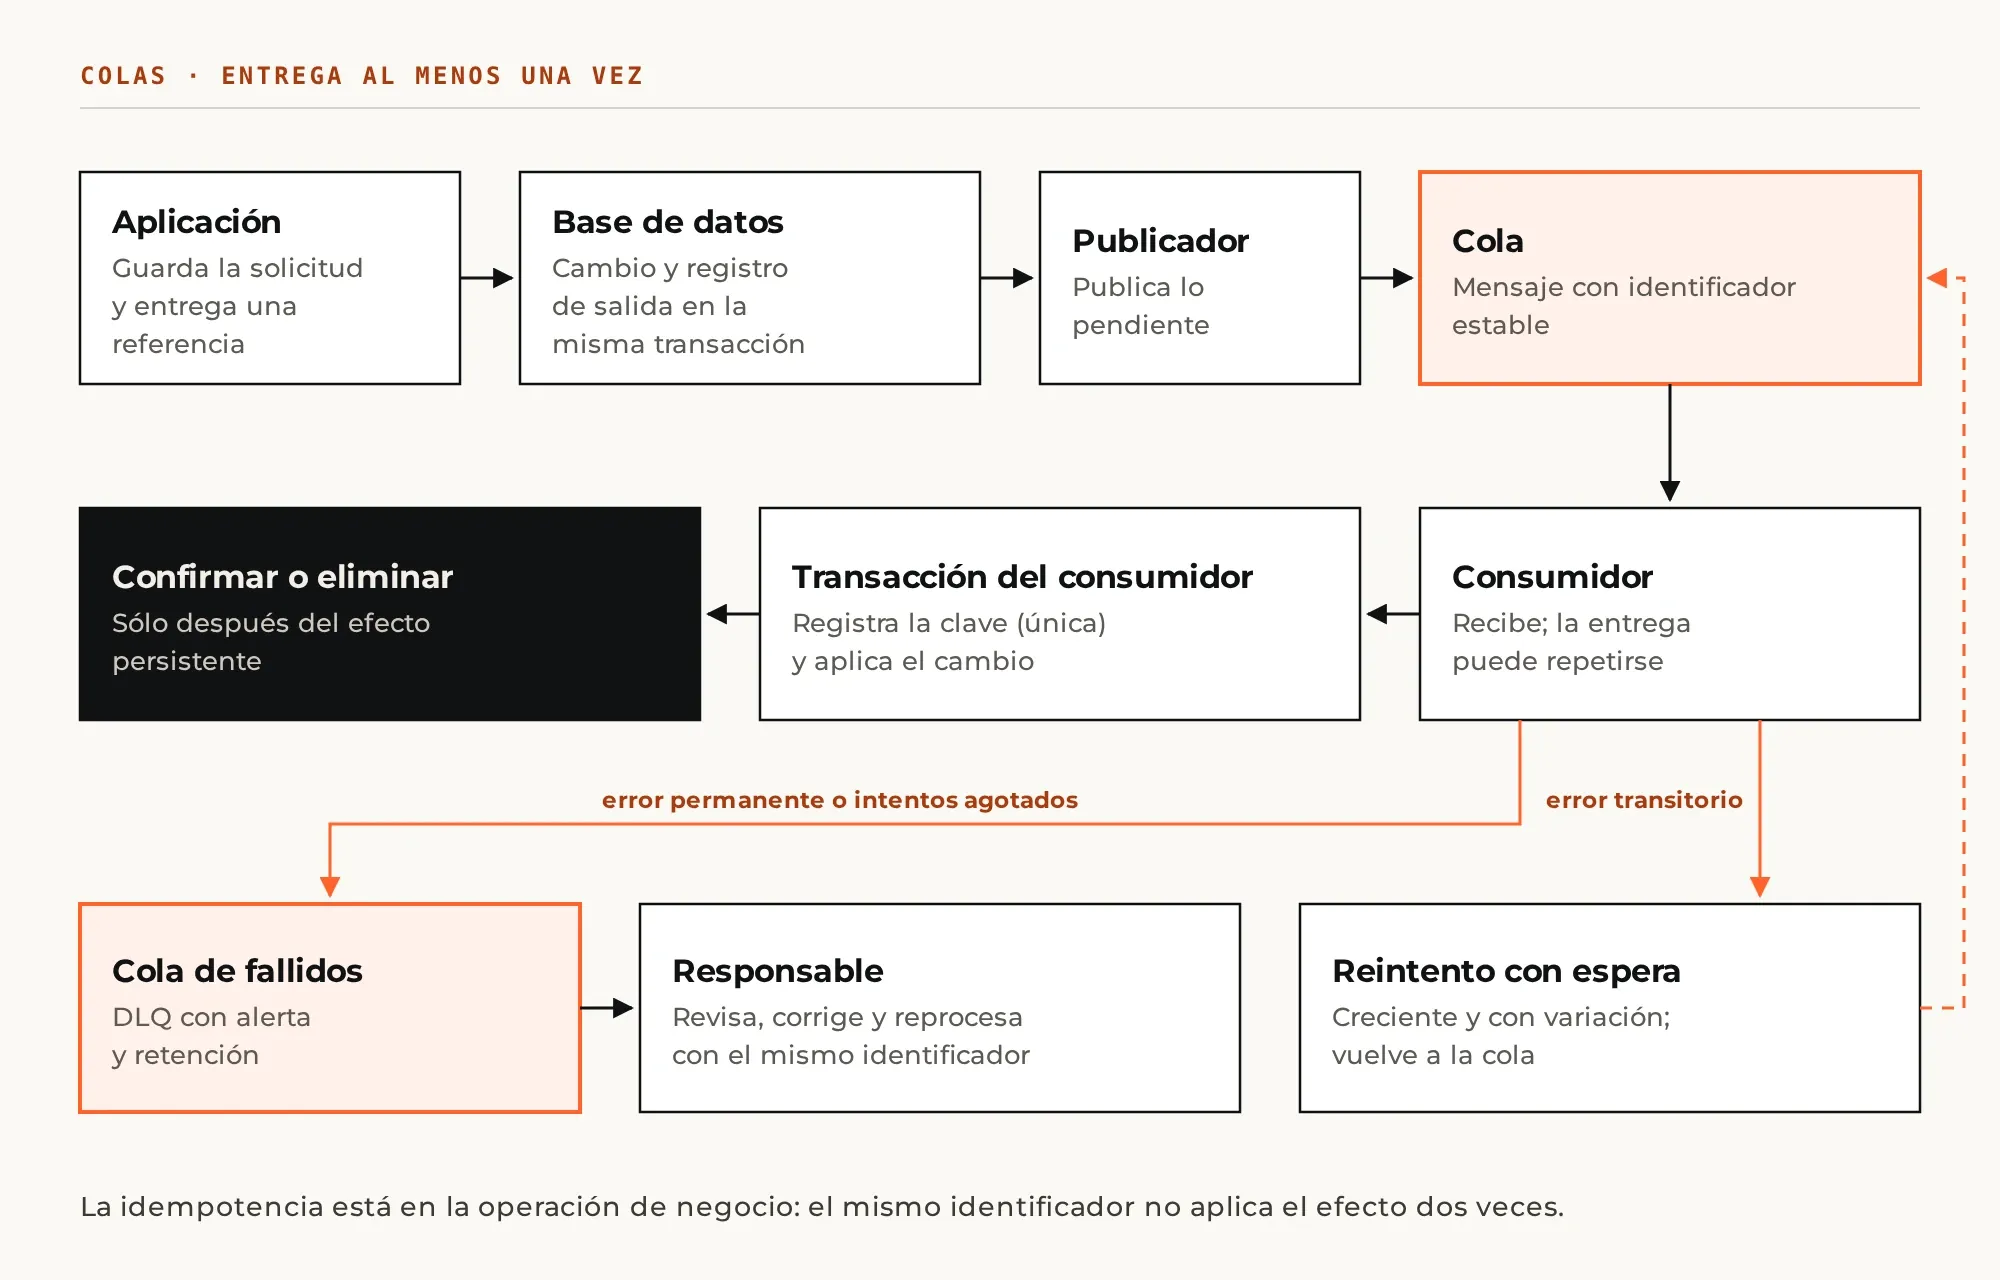
Confirmación posterior al efecto persistente
En el recorrido de un mensaje existen dos fronteras distintas: la entrega al intermediario y la ejecución de su efecto en la aplicación. En RabbitMQ, los publisher confirms y los acknowledgements del consumidor cubren cada frontera por separado. Que el broker confirme una publicación no indica que el consumidor haya ejecutado la operación de negocio.
El consumidor debe confirmar cuando ya persistió el resultado que permite considerar terminada la tarea. Si confirma antes, una caída posterior deja trabajo perdido desde el punto de vista del negocio. Si persiste primero y cae antes de confirmar, recibirá de nuevo el mensaje y deberá reconocer que el trabajo ya se hizo. Por eso la entrega es, en la práctica, «al menos una vez».
OCI Queue usa una interfaz diferente con la misma consecuencia: el consumidor recibe el mensaje, lo procesa y lo elimina. Durante el tiempo de visibilidad el mensaje queda oculto para otros consumidores; si vence sin eliminarse, puede entregarse otra vez. El procesamiento debe caber en esa ventana, o el consumidor debe extenderla a tiempo.
Idempotencia en la operación de negocio
Una operación es idempotente si repetirla con la misma intención no produce un efecto adicional. La técnica habitual combina un identificador estable del evento con un registro de operaciones completadas. El identificador debe sobrevivir a los reintentos: si se genera uno nuevo en cada publicación, ya no es posible reconocer que se trata del mismo trabajo.
La comprobación y el cambio deben coordinarse. Cuando ambos residen en la misma base de datos, una sola transacción registra el identificador y aplica el cambio, con una restricción única que impide registrar dos veces la misma operación. Una consulta previa aislada no basta: dos consumidores pueden consultar a la vez, no encontrar el registro y ejecutar ambos el efecto.
Cuando el efecto ocurre en una API externa, la transacción local no la abarca. Si el destino documenta una clave de idempotencia, debe usarse; si no, se necesita un mecanismo de reconciliación que permita consultar qué ocurrió. Repetir a ciegas una llamada cuya respuesta se perdió puede duplicar el efecto aunque la cola funcione correctamente.
Queda un tercer punto: la separación entre guardar el cambio inicial y publicar el mensaje. El patrón de salida transaccional (transactional outbox) guarda el cambio y un registro pendiente de publicación en la misma transacción local, y un proceso posterior publica ese registro. La publicación puede repetirse si se pierde una confirmación, por lo que el patrón complementa, y no sustituye, la idempotencia del consumidor.
Reintentos con espera definida
Antes de devolver un mensaje a la cola, el error debe clasificarse. Una dependencia temporalmente indisponible justifica otro intento; un documento con campos obligatorios ausentes requiere corrección. Tratar ambos casos del mismo modo consume capacidad y retrasa tareas que sí podrían completarse.
La política de reintentos combina una espera creciente con un límite de intentos o de tiempo total. Agregar variación aleatoria a la espera evita que todos los consumidores vuelvan a llamar al destino en el mismo instante. Como criterio de diseño, el mecanismo debe conservar el trabajo pendiente aunque el proceso se reinicie.
En RabbitMQ, devolver una entrega con requeue sin una política de demora puede provocar un ciclo rápido de reentregas. Las alternativas dependen de la versión y del tipo de cola: la documentación vigente de quorum queues describe un reintento con demora configurable mediante políticas a partir de RabbitMQ 4.3. En versiones sin esa función se evalúan una topología de espera o un programador persistente, con pruebas previas.
Las topologías basadas en TTL y dead lettering requieren una revisión específica. La expiración de mensajes no equivale a una hora exacta de ejecución, y combinar expiraciones distintas puede alterar el orden y la demora. Lo recomendable es registrar el próximo intento previsto y medir cuándo ocurre en realidad.
Cola de mensajes fallidos y responsable
La cola de mensajes fallidos (dead letter queue, DLQ) aísla el trabajo que no pudo completarse con la política normal. En OCI Queue, el servicio traslada a la DLQ los mensajes que superan el máximo configurado de entregas fallidas. La DLQ también tiene retención: el mensaje debe investigarse o recuperarse antes de que expire.
En RabbitMQ, un dead letter exchange enruta los mensajes hacia destinos configurados, y la cola receptora debe declararse y enlazarse explícitamente. La documentación de dead lettering advierte que el traslado puede fallar y que el comportamiento predeterminado no garantiza una transferencia segura; la modalidad at-least-once de las quorum queues requiere configuración explícita.
Una DLQ sin responsable es un depósito de trabajo perdido. Las alertas necesitan una persona o un equipo asignado, y cada mensaje debe conservar la razón del fallo y su identificador de correlación. El reproceso mantiene la identidad original del evento cuando representa la misma operación; si el contenido se corrige, se registra quién lo autorizó y qué cambió.
Pruebas en las fronteras del proceso
Las pruebas útiles introducen fallas en las fronteras: cuando el efecto ya se guardó pero la confirmación no llegó, y cuando una dependencia deja de responder. El criterio de aceptación es el resultado de negocio, no sólo los contadores del intermediario.
- Interrupción del consumidor antes y después de persistir el resultado, sin duplicación del efecto.
- Publicación con resultado incierto, repetida con el mismo identificador.
- Error permanente que llega a la DLQ y genera una alerta con responsable.
- Esperas que sobreviven a un reinicio y reprocesos que conservan la trazabilidad.
- Alertas por antigüedad del trabajo pendiente, además de profundidad de la cola.
Xterra Engine diseña arquitecturas de mensajería con estas pruebas de falla incluidas desde la primera entrega.