
Errores y reprocesos en Oracle Integration 3: un modelo para no perder ni duplicar trabajo
Una falla mal clasificada se convierte en una operación duplicada o en trabajo perdido. Modelo de clasificación, visibilidad y recuperación para integraciones en Oracle Integration 3.
Una integración puede recibir una solicitud, modificar el sistema destino y fallar inmediatamente después. Si la recuperación consiste sólo en volver a ejecutarla, el resultado posible es una operación duplicada o una parte del proceso pendiente que nadie identifica.
Este artículo propone un modelo de tratamiento de errores para Oracle Integration 3 en cuatro etapas: clasificar la falla, conservar su visibilidad, identificar el trabajo pendiente y recuperar sin duplicar. En cada etapa se distingue lo que ofrece la plataforma de lo que debe diseñar el equipo de integración.
Clasificación de la falla
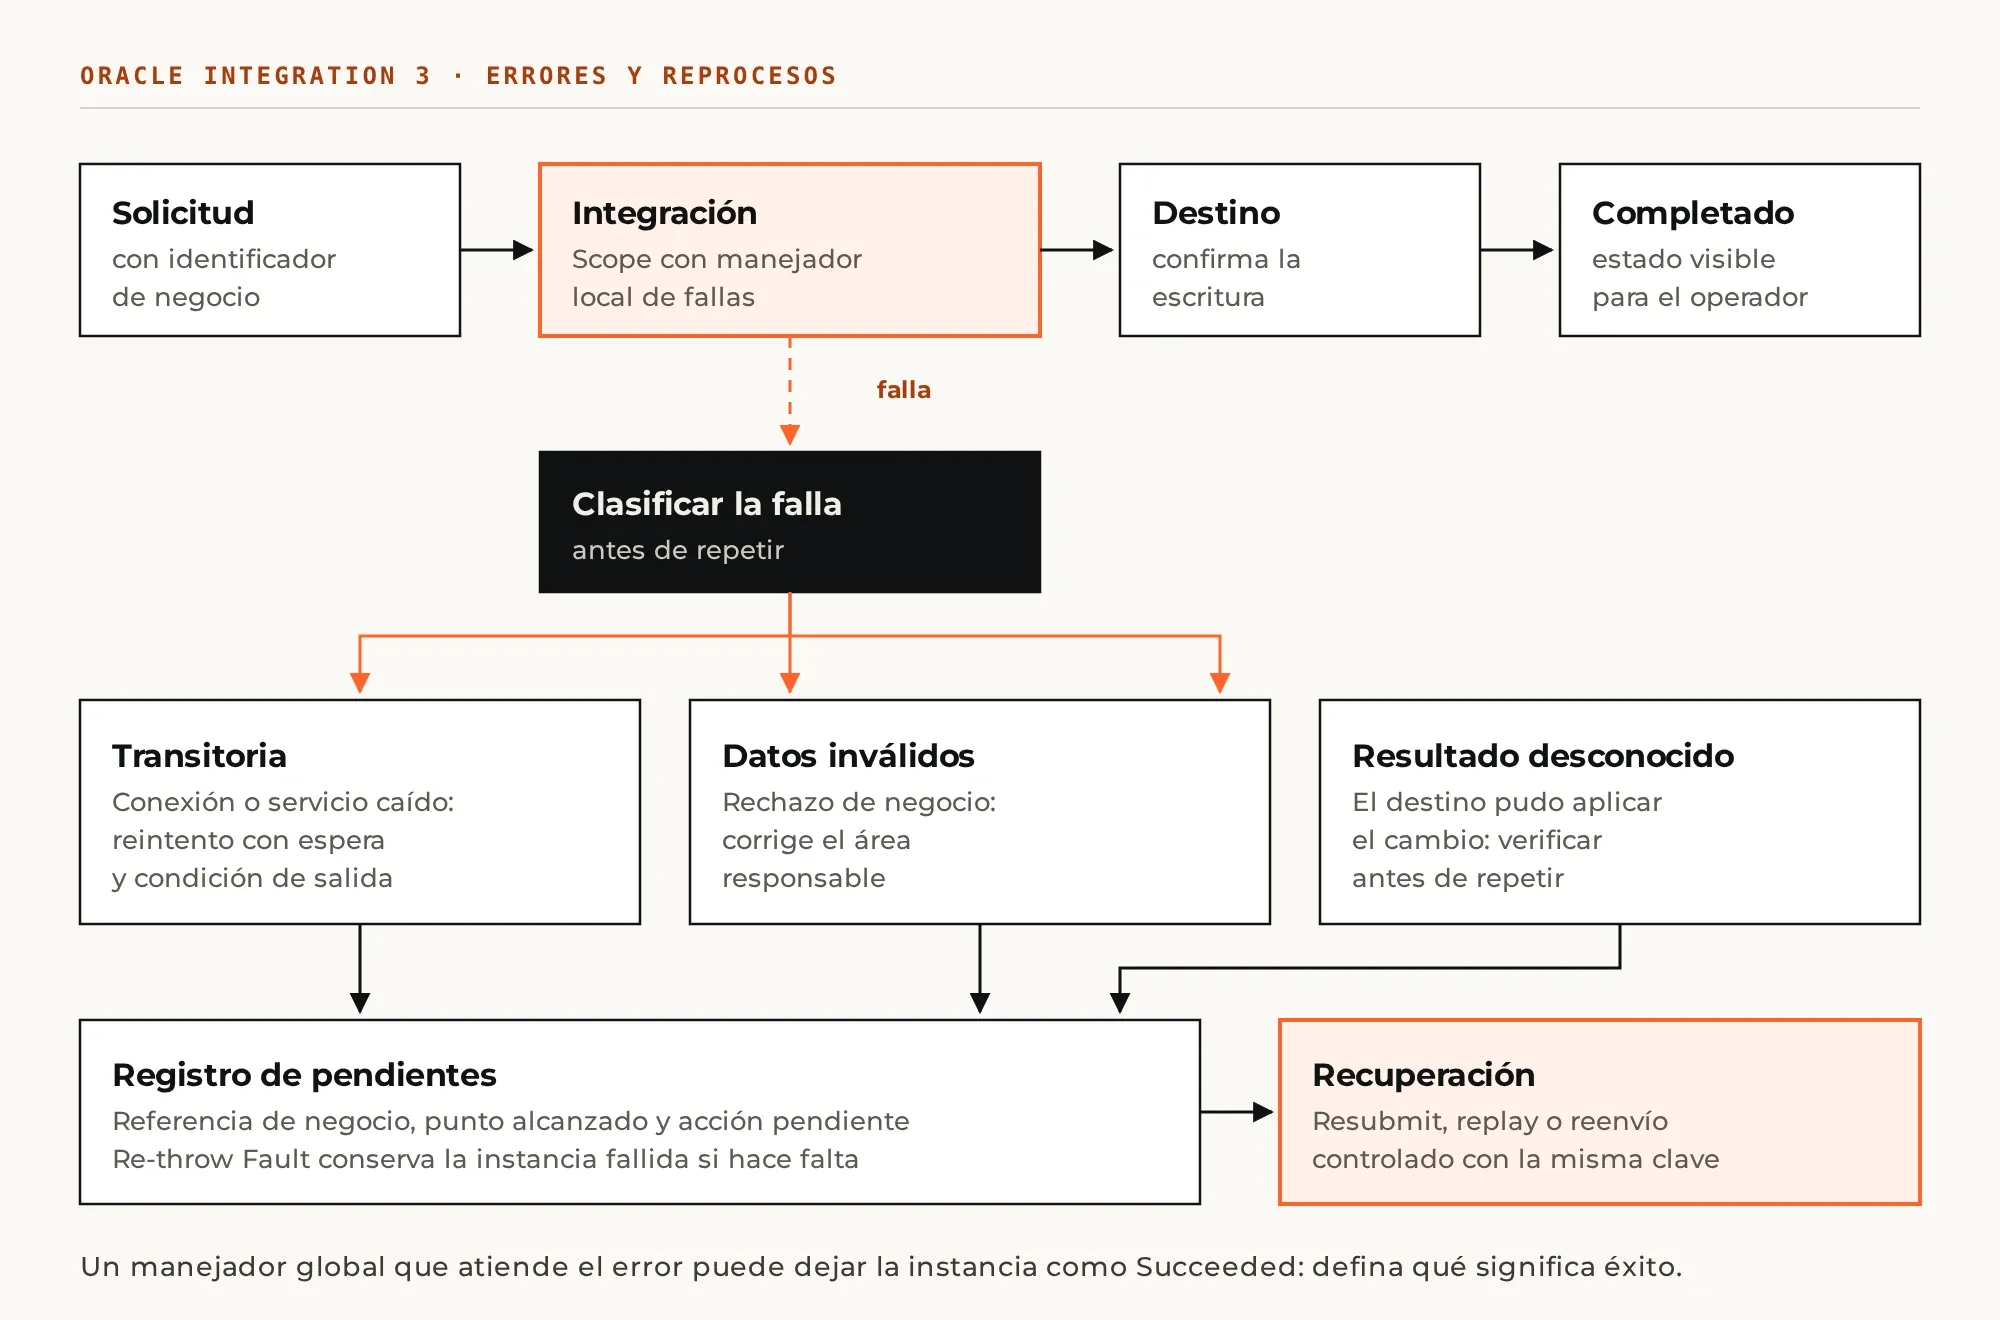
No todas las fallas admiten el mismo tratamiento. Una interrupción de conectividad puede justificar otro intento cuando el servicio se restablece; un documento rechazado por datos inválidos exige una corrección; un error de transformación exige revisar el mapeo o sus dependencias. Oracle describe estos escenarios en About Error Management.
Recomendamos una clasificación operativa que asigne una acción y un responsable a cada categoría. Un dato obligatorio ausente corresponde al área de negocio que lo origina; una conexión caída, al equipo técnico. Someter ambos casos al mismo ciclo de reintentos consume capacidad sin resolver ninguno.
Existe una tercera categoría que suele omitirse: el resultado desconocido. El destino pudo aceptar la escritura y la respuesta perderse en el camino. En ese caso, la ausencia de respuesta técnica no demuestra que el cambio de negocio no ocurrió, y repetir la escritura sin verificar puede duplicarla.
Por integración, conviene documentar qué operaciones pueden repetirse y cuáles requieren verificación previa, quién atiende los estados pendientes y cómo se decide su cierre. Estas reglas forman parte del procedimiento operativo y deben estar disponibles para quien atiende el incidente.
Scopes, propagación y significado de éxito
La acción Scope agrupa acciones e invocaciones y admite manejadores de fallas locales. Permite separar una operación cuya falla es recuperable de otra que debe detener el flujo. La documentación de Scope advierte una restricción relevante: en invocaciones a través del Connectivity Agent, las fallas deben atenderse en el manejador predeterminado, porque los manejadores con nombre no se procesan.
El manejador local cumple dos funciones: capturar contexto y decidir. Si una consulta auxiliar puede omitirse, la decisión se registra conforme al contrato del proceso. Si la operación obligatoria falló, el flujo no debe continuar como si el resultado estuviera confirmado.
La acción Re-throw Fault propaga la falla hacia el manejo de errores, pasando por el manejador global si existe, según Catch Faults with a Re-throw Fault Action. Notificar y propagar son decisiones distintas; cuando el operador necesita conservar la instancia fallida para analizarla, ambas deben diseñarse.
Un detalle con consecuencias: un manejador global que atiende el error puede dejar la instancia como Succeeded, según la guía de fallas globales. El éxito técnico no equivale al éxito de negocio. Si la falla se absorbe, debe quedar un estado de negocio duradero y consultable, independiente del estado técnico de la instancia.
Seguimiento del trabajo pendiente
Oracle Integration exige al menos un identificador de seguimiento por integración y permite filtrar instancias por esos valores, como se explica en Track Integration Instances. La elección importa: un número de pedido conocido por el usuario resulta más útil para soporte que una referencia interna aislada.
Conviene registrar por separado la identidad del trabajo y la de cada ejecución técnica. Un mismo documento puede atravesar varios intentos; todos corresponden a una sola intención de negocio y deben poder relacionarse entre sí y con las confirmaciones recibidas de los destinos.
Las páginas de errores muestran fallas, identificadores y el flujo de actividades; el contenido disponible depende de la configuración de trazado, documentada en Manage Errors. El nivel de trazado debe fijarse junto con el control de acceso, porque las cargas pueden contener datos sensibles.
Cuando el seguimiento debe durar más que la retención de la plataforma, recomendamos un registro de pendientes propio con tres campos mínimos: referencia de negocio, punto alcanzado y acción pendiente. Una notificación por correo no constituye evidencia de que el incidente quedó resuelto.
Resubmit y replay: dos mecanismos distintos
Resubmit, en la página Errors, recupera instancias fallidas identificadas como recuperables. Oracle Integration no las reenvía automáticamente, y el mecanismo no aplica a flujos síncronos ni a flujos programados con parámetros de programación, según Resubmit Failed Messages.
La recuperación puede continuar desde un punto guardado de la ejecución, por ejemplo después de una espera, o reiniciar desde el comienzo, según el diseño. No debe suponerse que se repetirá únicamente la invocación que falló. La ventana de recuperación y los límites de reenvío se consultan en la documentación vigente, sin fijarlos en manuales internos.
Replay es otra función: reinicia la ejecución desde el principio y aplica a instancias síncronas elegibles. Requiere activar Allow to run again, un disparador REST o AS2 y contenido estructurado; entre sus restricciones figura el uso del Connectivity Agent. La guía de replay detalla los requisitos y la comparación con la recuperación.
El procedimiento operativo debe indicar qué mecanismo se permite en cada integración y qué comprobaciones lo preceden. Si una instancia no admite ninguno de los dos, hace falta un reenvío autorizado desde el origen o desde un registro duradero. Una instancia descartada ya no puede recuperarse con Resubmit.
Idempotencia del segundo intento
Una operación es idempotente cuando repetir la misma intención no vuelve a aplicar su efecto. Se implementa con una clave estable acordada con el destino o con una comprobación de estado propia de la operación. La clave representa el trabajo; si se genera de nuevo en cada intento, pierde su función.
La secuencia «comprobar y luego escribir» admite condiciones de carrera cuando dos ejecuciones avanzan al mismo tiempo. Siempre que el destino lo permita, es preferible un mecanismo atómico: aceptación de la clave, restricción de unicidad u operación con semántica idempotente. La seguridad del reproceso se afirma sólo después de verificar las capacidades de la interfaz concreta.
Los reintentos dentro del flujo deben limitarse a errores transitorios, con una espera definida y una condición de salida. Esta política es lógica del diseño, no una garantía de recuperación automática de la plataforma. Al agotarse los intentos, el trabajo debe quedar visible para intervención, con la información necesaria para decidir el paso siguiente.
En lotes con resultados parciales, el punto de partida es identificar qué registros se confirmaron y cuáles quedaron pendientes. Reenviar el archivo completo sólo es seguro si el destino reconoce lo ya aplicado o si existe una regla equivalente probada. La misma precaución vale para integraciones que escriben en más de un sistema.
Prueba del procedimiento de recuperación
El procedimiento se valida con el equipo que atenderá el sistema, con datos controlados y verificando el resultado en el destino, además del estado de la instancia.
- Falla antes de escribir: el trabajo pendiente debe poder localizarse por su referencia de negocio.
- Pérdida de respuesta después de escribir: el segundo intento no debe duplicar el efecto.
- Rechazo de negocio: el registro debe quedar en espera de corrección, fuera del ciclo de reintentos.
- Mecanismo de recuperación: confirmar si corresponde Resubmit, replay o reenvío controlado desde el origen.
- Cierre: queda registrado quién verificó la confirmación final y quién cerró el incidente.
Una prueba completa deja evidencia de la operación de negocio y del tratamiento de la falla. Si el operador tuvo que improvisar algún paso, el procedimiento todavía no está listo para producción.
Xterra Engine diseña y ensaya procedimientos de recuperación para integraciones en Oracle Integration, con pruebas de falla incluidas en la entrega.